De las especificaciones al software: cómo construí mi propio Autonomous Engineering Harness
20 de octubre de 2026 · Arquitectura · Experimentos · Aprendizajes
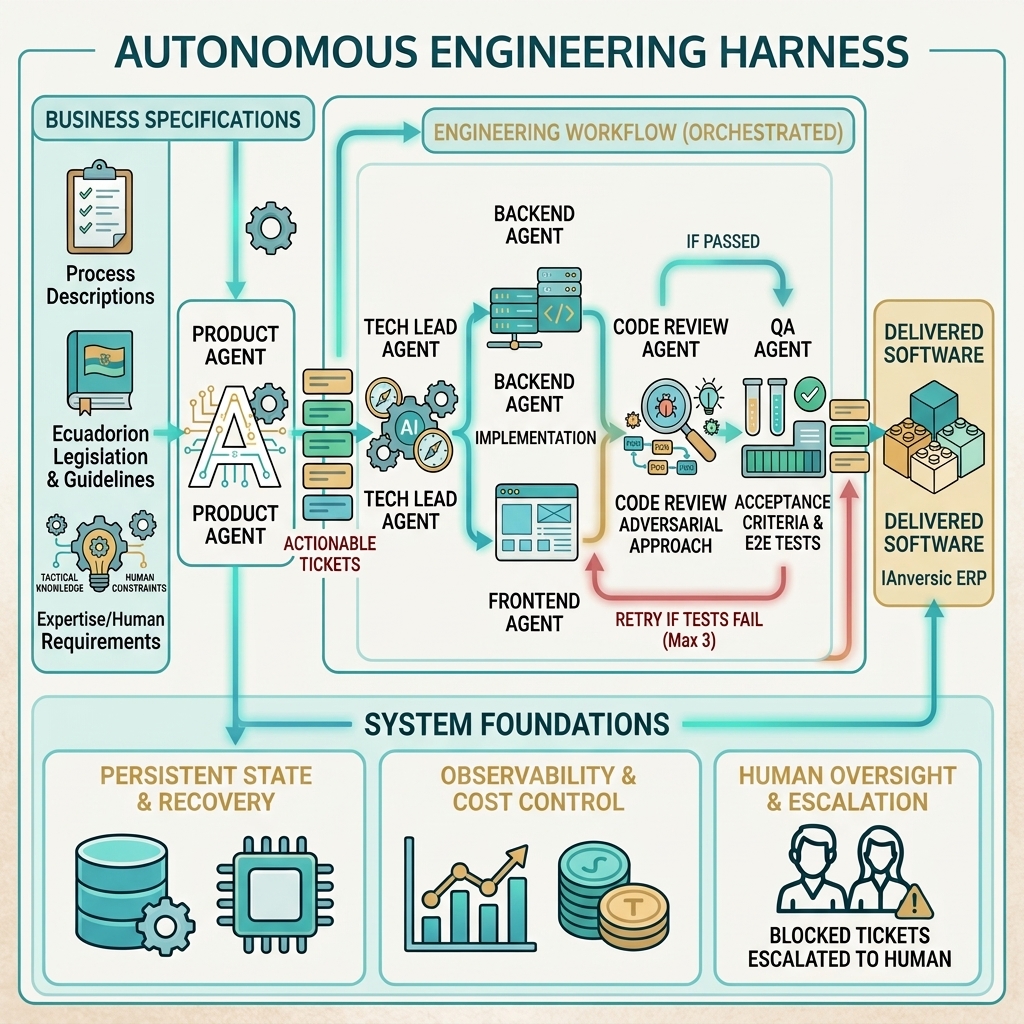
Un enfoque práctico sobre cómo construí mi propio sistema autónomo de ingeniería, diseñado para transformar especificaciones en software funcional mediante el uso de agentes de IA especializados, tareas estructuradas, un registro persistente de decisiones técnicas, además de procesos independientes de revisión de código y control de calidad (QA).
Todo empezó con un ERP
Hace unos meses, mi esposo me pidió ayuda para desarrollar varios módulos para un sistema de gestión empresarial (ERP). Como contador, durante los últimos años ha trabajado con algunos de los ERPs más grandes del mercado. A través de esa experiencia, identificó un problema recurrente: muchos sistemas son tan genéricos que las empresas terminan adaptando sus procesos para ajustarse al software, en lugar de que el software se adapte a sus necesidades reales. Él quería abordar el problema desde la perspectiva opuesta: entender primero cómo funciona una empresa y luego construir el software alrededor de sus procesos. Aportó el conocimiento del negocio y muchas ideas. Mi trabajo era descubrir cómo convertirlas en un producto funcional.
Como ingeniera de software, tenía experiencia en distintas etapas del ciclo de vida del desarrollo, incluida la creación de una aplicación móvil durante la pandemia de COVID-19. Desarrollar un ERP tampoco era algo completamente nuevo para mí: he estado construyendo módulos de Odoo desde 2017.
El reto no era simplemente construir el software. Era encontrar una forma confiable de hacerlo.
Por qué los agentes de programación necesitan un proceso de ingeniería
Con la fiebre actual del vibe coding, es tentador pensar que construir un buen producto es simplemente cuestión de pedirle a Claude, OpenAI u otro agente de programación que lo implemente.
Estas herramientas son increíblemente potentes y pueden hacer que el desarrollo de software sea mucho más accesible. Pero producir código no es lo mismo que entregar un producto confiable.
He estado experimentando con la IA en el desarrollo de software desde 2023, evaluando modelos de lenguaje de código abierto y propietarios, y utilizándolos en mi trabajo diario y en proyectos personales. He visto de primera mano cuánto pueden acelerar el desarrollo. También he aprendido que dar a los agentes de programación demasiada libertad sin restricciones claras, verificación y mecanismos de recuperación crea riesgos innecesarios.
Ya había explorado esta idea en un trabajo anterior, donde construí un flujo basado en Claude para ayudarme a resolver tareas de Jira. Conectaba el proceso desde un ticket de Jira hasta la implementación, la revisión de código y QA antes de crear un pull request.
Esa experiencia me dio un punto de partida. Pero construir un ERP requería algo más integral.
No solo necesitaba agentes que pudieran trabajar de forma independiente. Necesitaba un sistema de ingeniería que pudiera transformar los requisitos del negocio en software útil mientras mantenía el proceso estructurado, trazable y verificable.
Decidí combinar Spec-Driven Development con Claude Code, utilizando especificaciones como base para la implementación y habilidades de agentes especializados para coordinar el trabajo.
Mantuve la marca del producto y el diseño de UI/UX fuera del flujo de trabajo inicial de ingeniería. Utilicé un agente separado para explorar esos aspectos, lo que permitió que el harness de ingeniería se concentrara en traducir las especificaciones en software funcional.
Esa decisión ayudó a definir el alcance del problema que necesitaba resolver.
Los desafíos de ingeniería
Antes de diseñar el flujo de trabajo, identifiqué varios desafíos que no se podían resolver simplemente agregando más agentes.
1. Convertir diferentes fuentes de información en especificaciones accionables
Los requisitos provenían de varios lugares: descripciones de procesos, legislación ecuatoriana y directrices oficiales, la experiencia de mi esposo con operaciones comerciales reales y mis propios requisitos sobre gestión de usuarios, seguridad e integraciones.
Todas estas fuentes debían convertirse en especificaciones que los agentes de programación pudieran entender e implementar. Pero yo también necesitaba seguir participando en la interpretación de los requisitos y en la validación de decisiones del negocio. Un agente no debería asumir cómo debe funcionar un proceso comercial sin consultarme cuando se necesite una aclaración.
2. Dividir procesos complejos en tareas manejables
Las características grandes son difíciles de implementar y auditar como una sola unidad. Quería tickets pequeños y trazables que pudieran revisarse individualmente, considerando explícitamente las dependencias y el orden de implementación.
3. Mantener el código mantenible
Necesitaba comprender los cambios en el backend y el frontend que se estaban introduciendo. En mi experiencia, los agentes de programación a veces pueden producir comentarios innecesarios, pruebas redundantes o cambios desproporcionados respecto a la tarea original.
El objetivo no era eliminar la documentación o las pruebas. Era hacer que ambas fueran con propósito y proporcionales al cambio.
4. Hacer cumplir los límites
Los agentes necesitaban instrucciones claras sobre los estándares de implementación, los archivos permitidos y el alcance del proyecto. No debían realizar operaciones no autorizadas ni acceder a recursos fuera de sus límites previstos.
5. Incorporar verificación independiente
La implementación no podía ser el paso final. Necesitaba etapas separadas de revisión de código y QA capaces de cuestionar la solución, detectar defectos y devolver tickets para su corrección.
6. Preservar el contexto y recuperarse de fallas
Los flujos de trabajo de los agentes necesitan un estado persistente. Una vez escuché a un autor describir a los agentes de programación como ingenieros senior con muy mala memoria. Esa analogía me resonó.
El sistema necesitaba preservar el estado del ticket, las decisiones, los hallazgos relevantes y el progreso de la sesión para que el trabajo pudiera reanudarse después de interrupciones sin depender por completo del contexto de una sola conversación.
7. Controlar el consumo de tokens
El costo era otra restricción de ingeniería. Quería medir el uso de tokens junto con los tickets completados para poder identificar patrones costosos y mejorar el flujo de trabajo, en lugar de tratar el consumo como un costo inevitable de la automatización.
Diseñando un equipo de desarrollo de agentes
Abordé el problema pensando en cómo funciona un equipo de desarrollo de software. Mi inspiración también vino de los colegas con los que tuve la oportunidad de trabajar en Newsela, donde aprendí de grandes profesionales.
En lugar de tratar a cada agente como un desarrollador de propósito general, dividí el trabajo en seis roles especializados coordinados a través de un flujo de trabajo orquestado definido en un esquema:
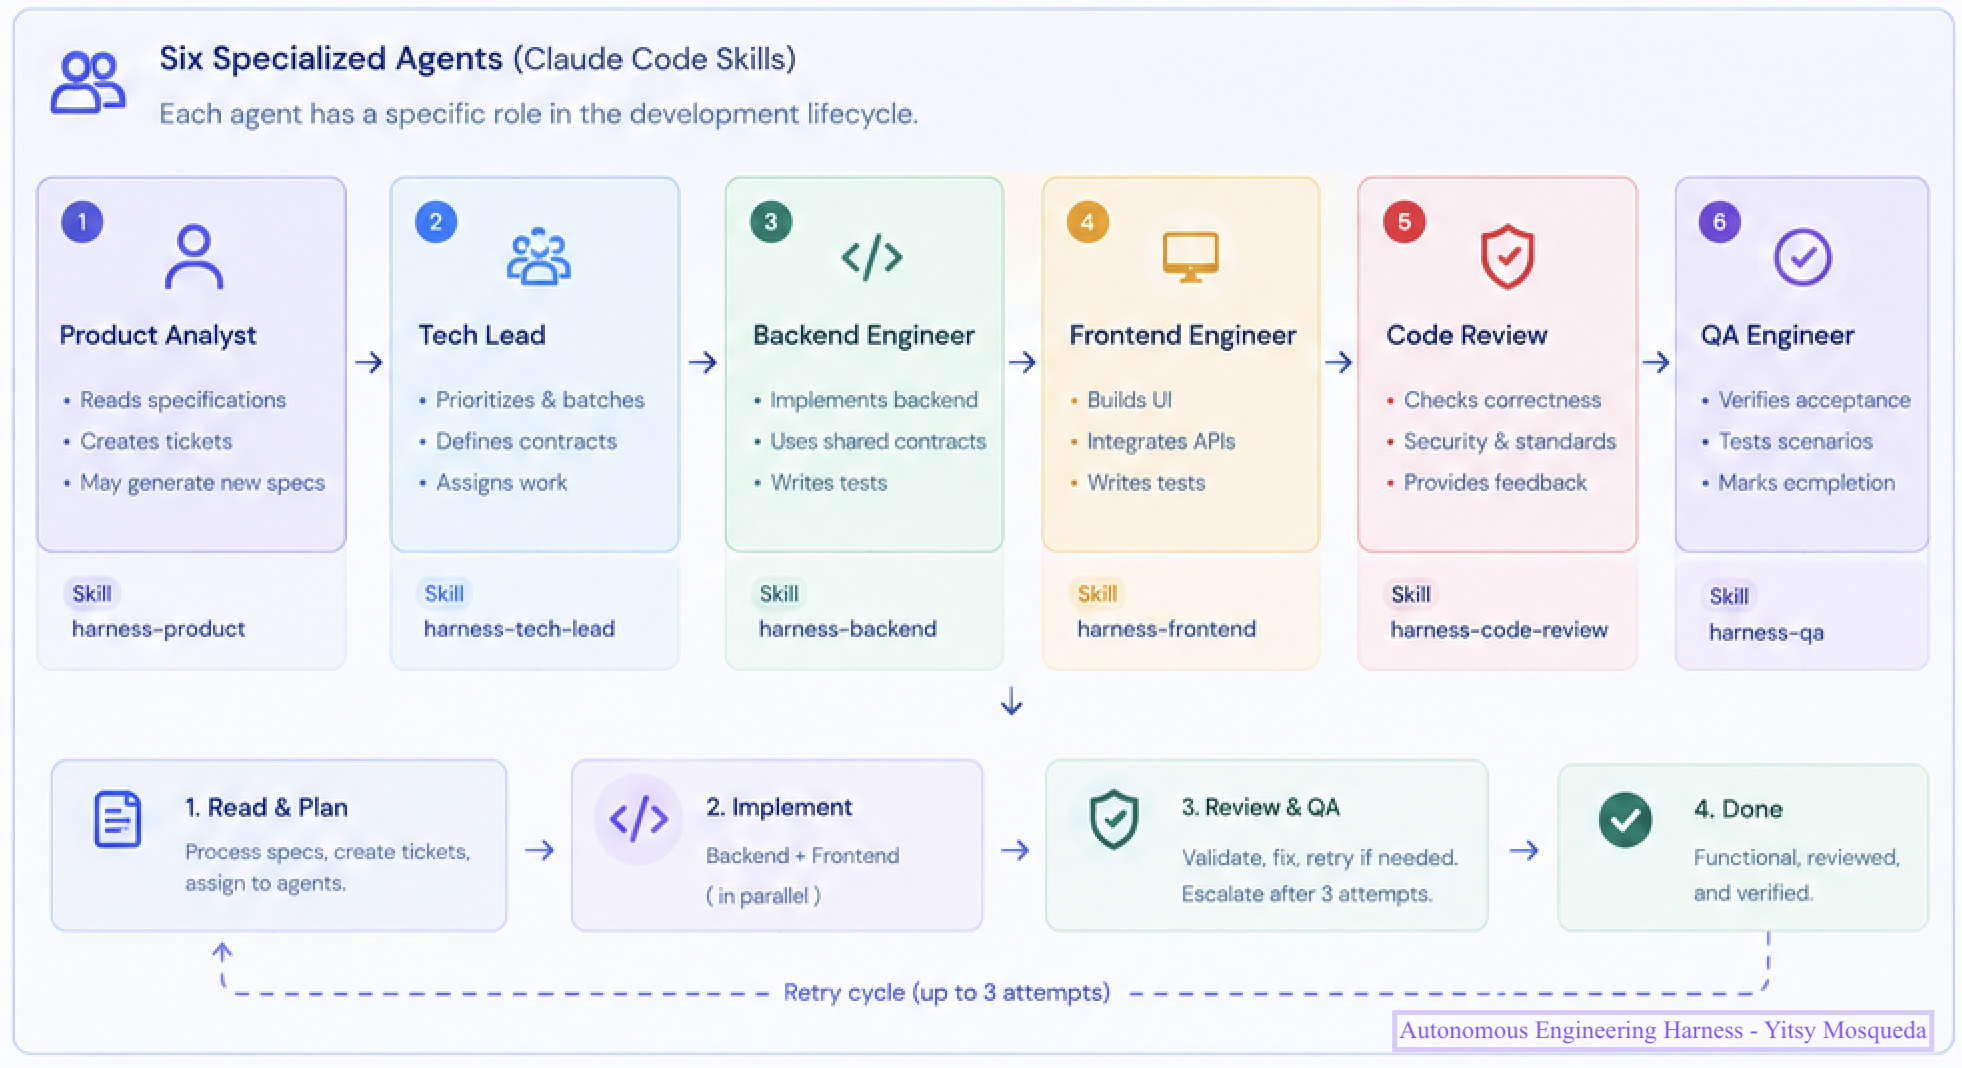
The agent workflow coordinates requirement analysis, planning, implementation, code review, and QA.
1. Product Agent
El Product Agent analiza las especificaciones y materiales de apoyo, que pueden incluir legislación, manuales, sitios web y documentación de procesos.
Ayuda a identificar información faltante y a dividir los requisitos en épicas y tickets autocontenidos. Cuando una decisión del negocio no está clara, debe consultarme a mí en lugar de inventar una solución.
El objetivo es convertir requisitos potencialmente ambiguos en trabajo accionable sin perder la intención comercial original.
2. Tech Lead
El Tech Lead organiza el backlog, considera las dependencias, define los contratos de implementación y asigna el trabajo a los agentes correspondientes.
Los tickets se organizan en lotes de implementación, considerando las dependencias antes de comenzar el trabajo. El objetivo es completar un conjunto coherente de tareas relacionadas antes de pasar a la siguiente etapa, lo que facilita el seguimiento y la auditoría del progreso.
El Tech Lead también determina si un ticket pertenece al flujo de trabajo del frontend o del backend.
Ejemplo de esquema utilizado:
{
  "schema_version": "1.0",
  "ticket_id": "TKT-{NNNN}",
  "feature_id": "EPIC-{MODULE}-{AREA}",
  "title": "{Verb + short description}",
  "source_spec_file": "ruta/a/especificacion.md",
  "user_story_ids": ["US-x.y"],
  "class": "layer | migration | contract | seed_data | module | core",
  "phase": "{catalogs | core | reporting | iam | tenancy | config}",
  "blocker_criteria": [
    {
      "code": "AC-01",
      "description": "{Criterio de aceptación tangible 1}"
    }
  ],
  "is_active": true,
  "status": "backlog"
}
3. Frontend and Backend Agents
Estos agentes implementan los tickets asignados dentro de su alcance definido y siguiendo los estándares de código del proyecto.
Se espera que aborden los requisitos del ticket sin introducir cambios innecesarios. Una vez completada la implementación, el ticket pasa a revisión de código en lugar de marcarse como terminado de inmediato.
4. Code Review Agent
El Code Review Agent adopta un enfoque adversarial. Su trabajo no es confirmar que el código se ve razonable, sino buscar formas en las que la implementación podría fallar.
Examina la corrección, la seguridad, la mantenibilidad y la posible deuda técnica en el código afectado. Si encuentra problemas, el ticket regresa a la etapa de implementación con hallazgos que deben abordarse antes de QA.
Un ticket puede pasar por hasta tres intentos antes de ser marcado como BLOCKED y escalado a mí para una decisión.
5. QA Agent
QA es una etapa de verificación independiente, no solo otra revisión de código.
El QA Agent verifica si la implementación satisface los criterios de aceptación del ticket y si las pruebas relevantes pasan. Para los cambios en la UI, también puede usar un navegador para verificar el comportamiento real en lugar de depender exclusivamente de la inspección del código.
Cuando QA encuentra un problema, el ticket regresa a la implementación y debe pasar la verificación nuevamente. Después de tres intentos no exitosos, se marca como BLOCKED para intervención humana.
Separar la revisión de código de QA le da al flujo de trabajo dos puntos de control distintos: uno enfocado en la calidad de la implementación y otro en si el comportamiento entregado cumple con los requisitos.
Orquestación, estado y recuperación
Los agentes especializados por sí solos no son suficientes. El flujo de trabajo también necesita una forma de coordinarlos y preservar lo que sucede en cada etapa.
Cada agente informa su estado, mientras que los registros de los tickets rastrean el progreso y los archivos afectados. Esto permite inspeccionar en qué se está trabajando, qué ha cambiado y en qué parte del pipeline se encuentra un ticket.
El harness también persiste la información de la sesión y los hallazgos importantes. Un resumen de la sesión preserva el contexto necesario para continuar el trabajo después de una interrupción, mientras que un mecanismo de memoria separado (por ejemplo, registros de decisiones de arquitectura o ADRs como ADR-004-serve-ui-baseline.json, protegiendo prototipos simulados) registra las decisiones y reglas relevantes que deben conservarse.
Ambos se consultan cuando comienza una nueva ejecución del harness, lo que ayuda a que el flujo de trabajo se recupere sin tener que reconstruir cada decisión desde cero.
El resultado es un proceso con estado en lugar de una colección de prompts desconectados. El flujo de trabajo puede rastrear el progreso, reanudar el trabajo interrumpido y redirigir los tickets fallidos a la etapa correspondiente.
Reduciendo el consumo de tokens
Una vez que el flujo de trabajo estuvo en marcha, comencé a medir el costo de realizar el trabajo.
Rastreé el uso de tokens por sesión junto con la cantidad de tickets completados. Esto me dio una forma de comparar los cambios en las instrucciones de los agentes con su impacto real en el proceso de desarrollo.
Un patrón se destacó: las sesiones que ejecutaban más de dos agentes de forma concurrente estaban asociadas con una mayor frecuencia de picos muy grandes de consumo de tokens, a veces superando los 150K tokens.
Ajusté el flujo de trabajo para limitar la ejecución paralela a dos agentes y prohibir explícitamente la ejecución de subagentes anidados. Ese cambio por sí solo redujo significativamente el consumo de tokens en algunas sesiones.
Este es un ejemplo de por qué considero que el harness es un sistema de ingeniería en lugar de simplemente un script de orquestación de agentes. Su comportamiento necesita ser observado, medido y mejorado al igual que cualquier otro sistema de software.
El objetivo no es minimizar los tokens a cualquier costo. Es usarlos de manera eficiente mientras se preserva la calidad de la implementación, la profundidad de la revisión y la verificación confiable.
Del harness a IAnversic ERP
La versión inicial de IAnversic ERP ya se encuentra funcionando, construida utilizando este flujo de trabajo de Autonomous Engineering.
El resultado más importante hasta ahora no es la cantidad de líneas de código generadas ni el número de agentes involucrados. Es tener un proceso repetible para transformar especificaciones en software manteniendo la trazabilidad y la verificación independiente.
Los módulos principales del ERP y el sistema de autenticación han sido implementados y validados a través de pruebas automatizadas, flujos end-to-end, pruebas manuales y verificación independiente humana.
El proceso sigue siendo iterativo. Los agentes pueden implementar, revisar, probar y reintentar el trabajo, pero los tickets que superan el límite de reintentos se escalan en lugar de tratarse silenciosamente como completados. Yo sigo involucrada en los requisitos, las decisiones importantes y la validación de hitos.
Todavía queda trabajo por hacer a medida que el producto evoluciona. La implementación actual es un hito importante, no una afirmación de que todos los escenarios comerciales o requisitos de producción hayan sido resueltos.
Lo que he aprendido hasta ahora
Construir este harness ha reforzado una idea que creo que es fácil de pasar por alto en la conversación actual sobre el desarrollo con IA:
El valor de los agentes de programación depende no solo de lo que pueden generar, sino también del sistema de ingeniería que controla, verifica y mejora su trabajo.
Autonomía no significa eliminar la disciplina de ingeniería. Significa hacer que el flujo de trabajo sea capaz de avanzar de forma independiente dentro de límites explícitos, preservando su estado, detectando fallas y escalando problemas cuando no pueda resolverlos de manera segura.
Para mí, Autonomous Engineering es un intento de hacer que esto sea práctico: un flujo de trabajo reutilizable que conecta especificaciones, implementación, revisión de código, QA y recuperación en un solo proceso trazable.
Lo construí para resolver un problema real mientras desarrollaba IAnversic ERP, pero luego lo usé en otros proyectos. Continúo refinándolo a medida que aprendo de los trabajos de implementación reales, las fallas y las mediciones de costos.
La prueba más útil de este enfoque no será lo impresionante que se vea el flujo de trabajo en papel. Será si me ayuda de manera constante a entregar software mantenible que resuelva problemas comerciales reales.