IAnversic EVAL
Evaluación de IA con calidad medible
Una plataforma de evaluación de IA creada para hacer medible la calidad de las aplicaciones de IA, permitiendo evaluaciones estructuradas, comparación de modelos y prompts, y detección de regresiones mediante ejecuciones reproducibles.
Visión general del proyecto
Una plataforma de ingeniería de calidad que ayuda a evaluar, comparar y mejorar aplicaciones basadas en LLMs mediante experimentos estructurados y reproducibles.
Combina verificaciones deterministas con LLM-as-a-Judge para medir la calidad frente a criterios explícitos: datasets, comparación de modelos/prompts, ejecuciones y detección de regresiones.
Ver producto en vivoArquitectura
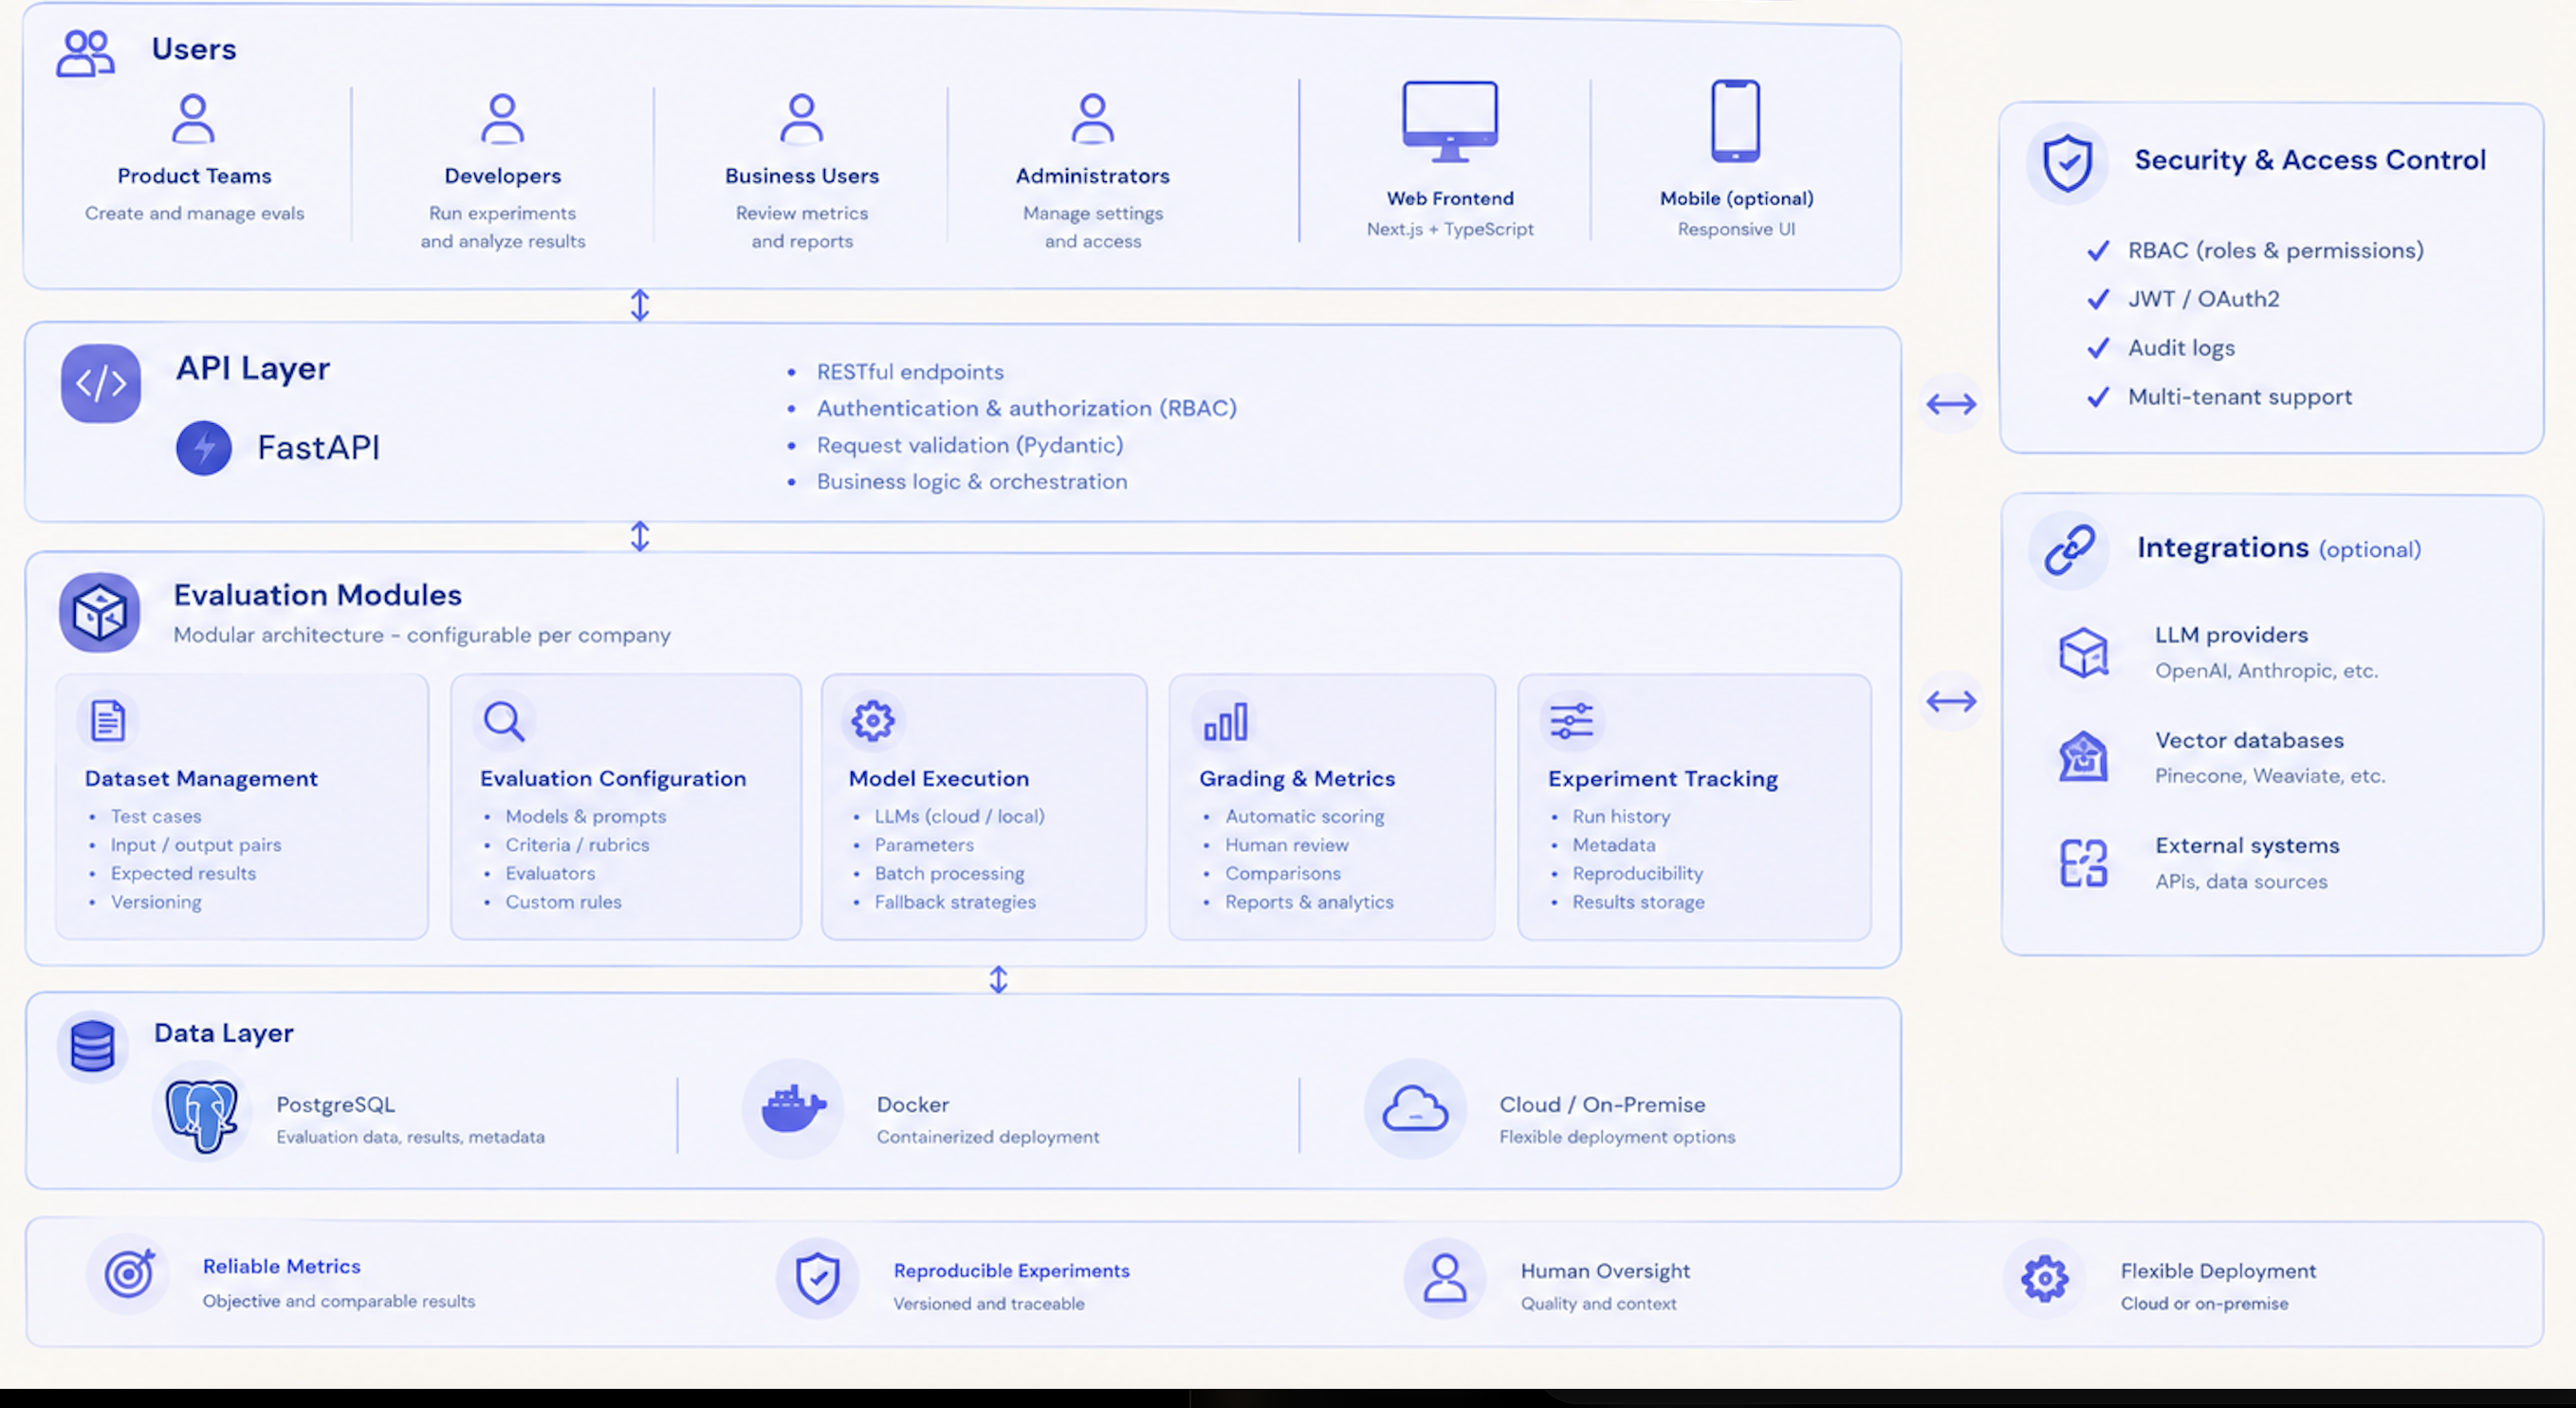
Decisiones de diseño
- Evaluadores deterministas primero; jueces LLM solo cuando se requieren.
- Calibración de sesgo en jueces LLM con rúbricas explícitas.
- Reproducibilidad con temperatura 0 y prompts versionados.
Retos técnicos
- Evitar falsos negativos en evaluaciones estructuradas.
- Alinear las puntuaciones automáticas con el juicio humano.
- Distinguir regresiones reales del ruido.
Evidencia de pruebas y validación
Múltiples capas de verificación en la ejecución de evaluaciones, calificación y detección de regresiones.
IAnversic EVAL combina pruebas automatizadas, integración con proveedores reales y comprobaciones de regresión para validar flujos de evaluación de LLM reproducibles.
01Pruebas automatizadas
Las pruebas cubren la lógica de evaluación, evaluadores, métricas, validación de entrada y transiciones de estado de ejecución.
Evidencia: informes de pruebas y registros de ejecución.
02Pipeline de evaluación
Las verificaciones de extremo a extremo validan la ejecución de datasets, invocación de modelos, calificación y persistencia de resultados usando proveedores simulados y de OpenAI.
Evidencia: informes de evaluación, resultados de evaluadores y registros de ejecución.
03Detección de regresiones
Las comparaciones con línea base aplican umbrales configurables a puntuaciones de calidad, latencia, coste, uso de tokens y fallos. La CLI puede hacer fallar pipelines CI/CD cuando se detectan regresiones.
Evidencia: comparaciones con línea base, veredictos de regresión y códigos de salida de la CLI.
04Reproducibilidad y benchmarks
Las versiones inmutables de datasets y prompts permiten ejecuciones de evaluación trazables. El benchmark simulado de 500 muestras se completa en aproximadamente 2–4 segundos en un portátil de desarrollo; esto mide la ejecución de la plataforma con un proveedor simulado, no el rendimiento de modelos reales.
Evidencia: manifiestos de ejecución, informes de benchmark y resultados de evaluación versionados.
Estado actual y próximos pasos
Validado con proveedores simulados y de OpenAI, respaldado por pruebas automatizadas y comprobaciones de regresión.
Próximos pasos: ejecutar benchmarks multi-modelo, medir throughput, evaluar significancia estadística y expandir a evaluación humana, RAG y de agentes, seguido de observabilidad de IA.
Contactar sobre este proyecto